El aprendizaje por refuerzo (RL) utiliza recompensas para capacitar a los estudiantes para que resuelvan problemas y completen tareas con mayor éxito.
El modelado impulsa este proceso. Los trabajadores producen resultados: secuencias de muestras de resultados, acciones e interacciones ambientales. El marco RL predice los resultados, actualiza las ponderaciones del modelo y devuelve esas ponderaciones a los trabajadores para la siguiente ronda.
A medida que se determina el entrenamiento de RL, muchas tareas computacionales, iteraciones lentas, actualizaciones intensas y fallas de los trabajadores desperdician energía de la GPU y ralentizan el entrenamiento.
NVIDIA Dynamo proporciona la capa de rendimiento para abordar estas limitaciones, ayudando a los equipos a generar modelos de capacitación aprobados y completar tareas de capacitación rápidamente.
Esta publicación de blog explica las variables que ralentizan el entrenamiento de RL y cómo Dynamo las aborda con enrutamiento, actualizaciones de peso de ModelExpress y recuperación.
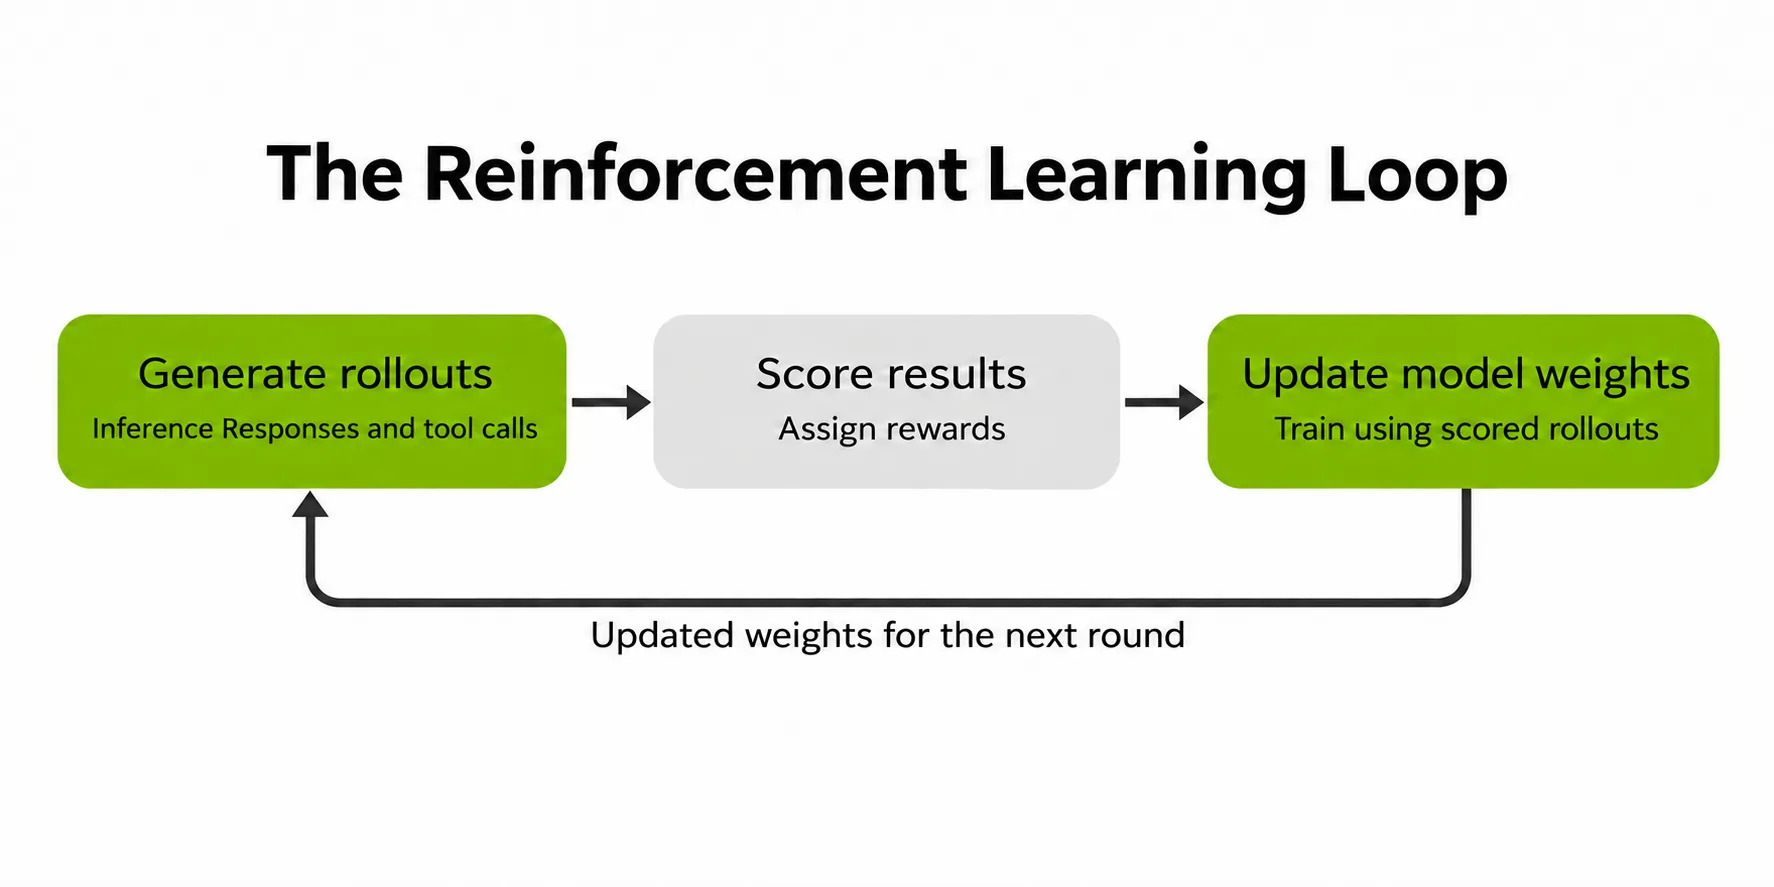
1. ¿Por qué RL necesita compartir infraestructura de producción?
Puede haber sólo una respuesta por opinión. La generación de código móvil permite la depuración, la depuración, la llamada a herramientas y las pruebas. Estas diferencias crean una carga de trabajo desigual entre el personal encargado de tomar decisiones.
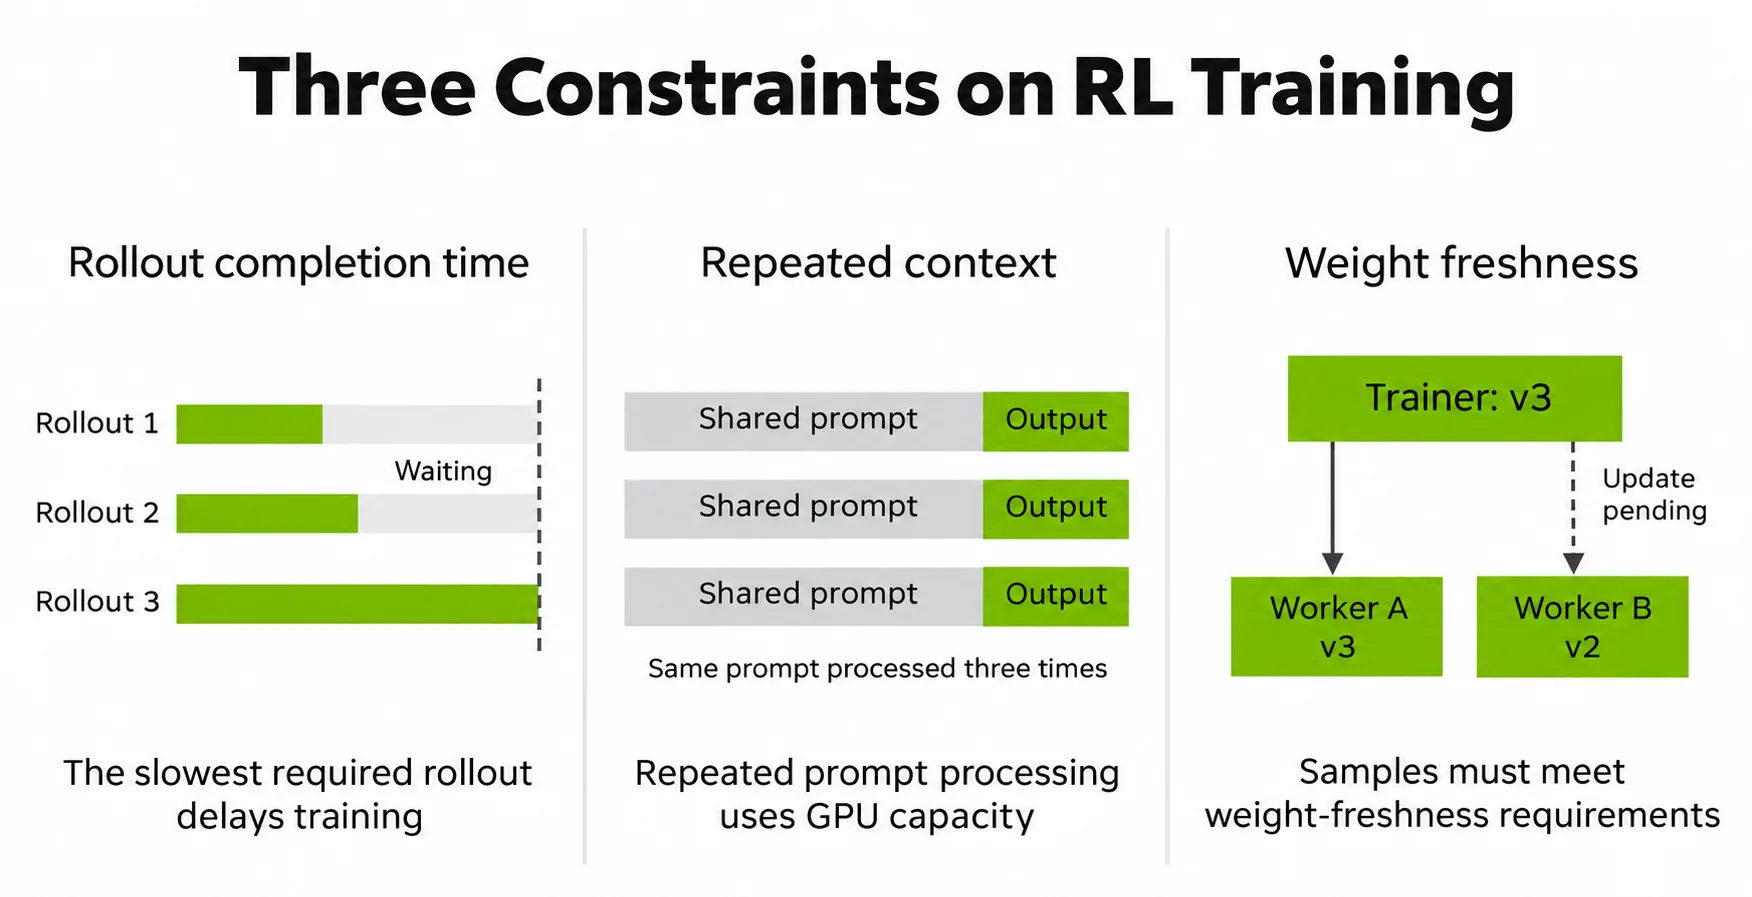
Hay tres limitaciones que determinan la capacidad de una actividad de este tipo para apoyar la formación.
Tiempo de finalización de la producción. Al formar a un grupo de estudiantes, la lentitud requerida puede retrasar el siguiente paso. Distribuir aplicaciones que computan entre GPU no necesariamente distribuye cargas de trabajo.
Contexto repetitivo. Muchos intentos comienzan con instrucciones, descripciones de trabajo o contextos de repositorio de código similares. La GPU se quedará sin energía antes de que se lance una nueva versión.
Nuevo peso. El entrenamiento genera nuevos pesos de muestra a lo largo de la ejecución. Los empleados deben recibirlos de acuerdo con los requisitos del algoritmo para el muestreo sin consentimiento.
Abordar estas limitaciones permite a los equipos completar más iteraciones dentro de un presupuesto establecido. La optimización adecuada se basa en la restricción que limita la carga de trabajo.
2. La arquitectura de Dynamo para RL
Dynamo se encuentra entre el equipo y el personal que toma las decisiones. El marco RL proporciona aplicaciones generacionales; El Dinamo les conducirá a la fuerza necesaria; Los motores de decisión hacen el modelado.
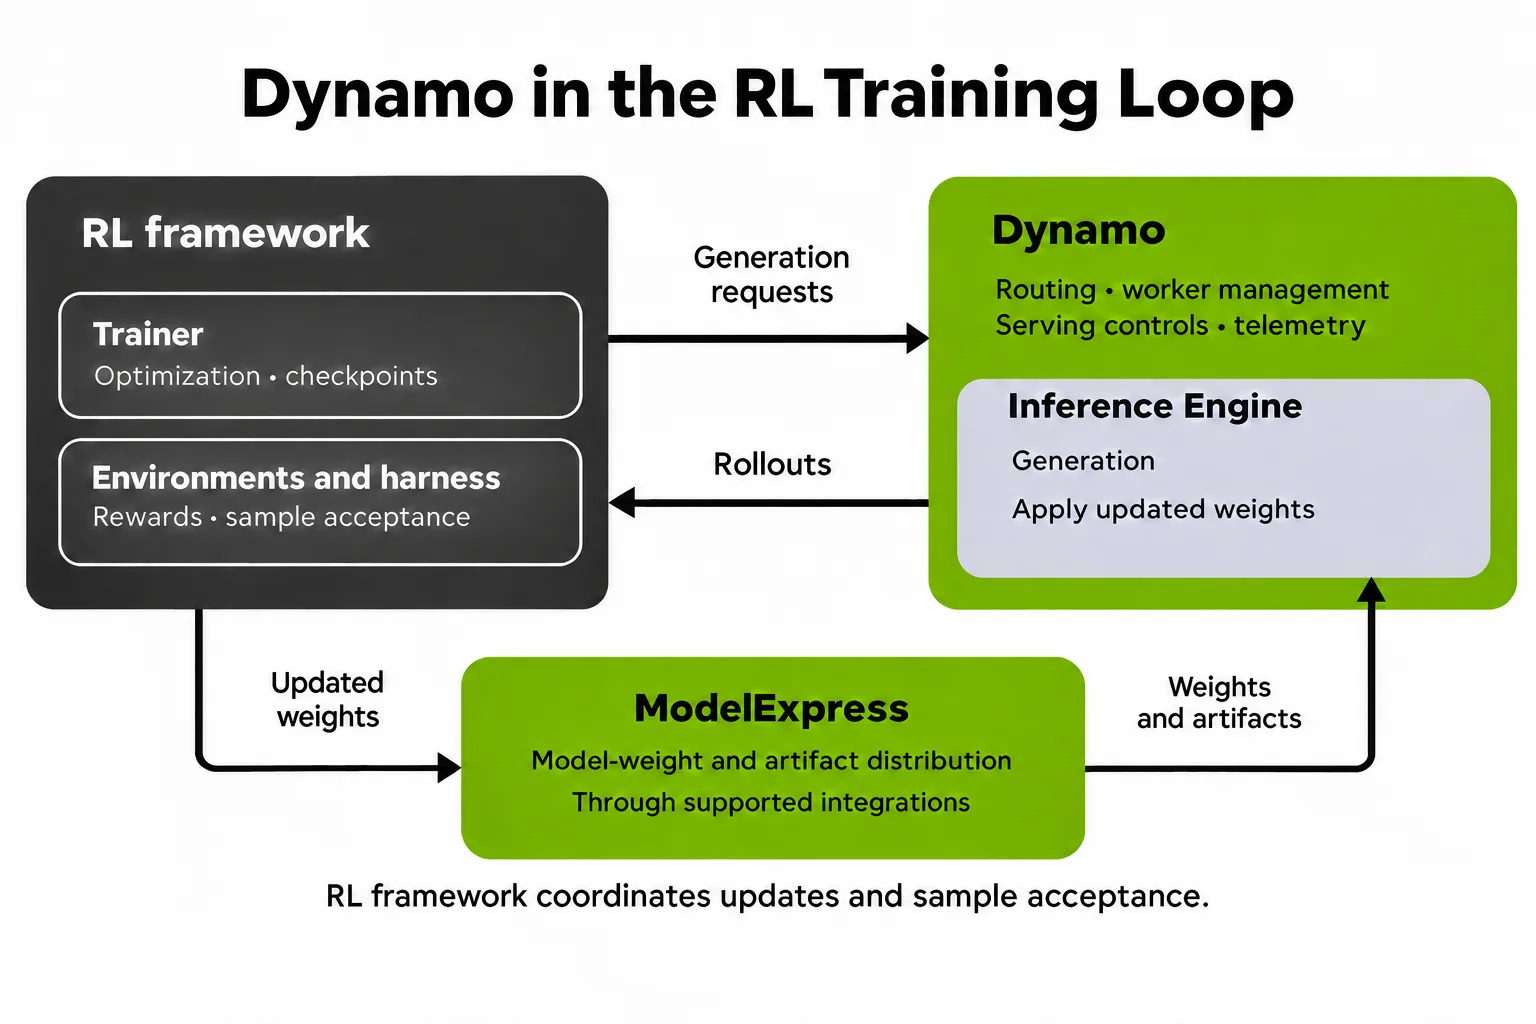
Las responsabilidades de cada sección serán claras:
| Unidad | Estado |
|---|---|
| marco de realidad virtual | Optimización, costos, entornos, puntos de control y aceptación de modelos. |
| Dinamo | Enrutamiento, gestión de personal, gestión de servicios y telecomunicaciones. |
| El motor de decisiones | Generando y usando cepas actualizadas |
| ModeloExpress | Ponderación del modelo y distribución de recursos a través de insumos de apoyo. |
La cría y el control del peso siguen caminos diferentes. Las aplicaciones que utilizan un backend de tareas compartidas actualizan tareas que se centran en los trabajadores especificados bajo el control del marco. Esto permite que el marco determine cuándo los empleados producirán las muestras y los resultados necesarios para la capacitación.
La separación permite a los equipos mejorar el desempeño sin transferir la propiedad del proceso de aprendizaje. Las decisiones de ruta determinan dónde ocurre la generación; el marco determina si los estudiantes graduados cumplen con sus requisitos de formación. Consulte la referencia de instalación de RL.
3. Cómo acelera Dynamo el enrutamiento, la distribución de carga y la recuperación
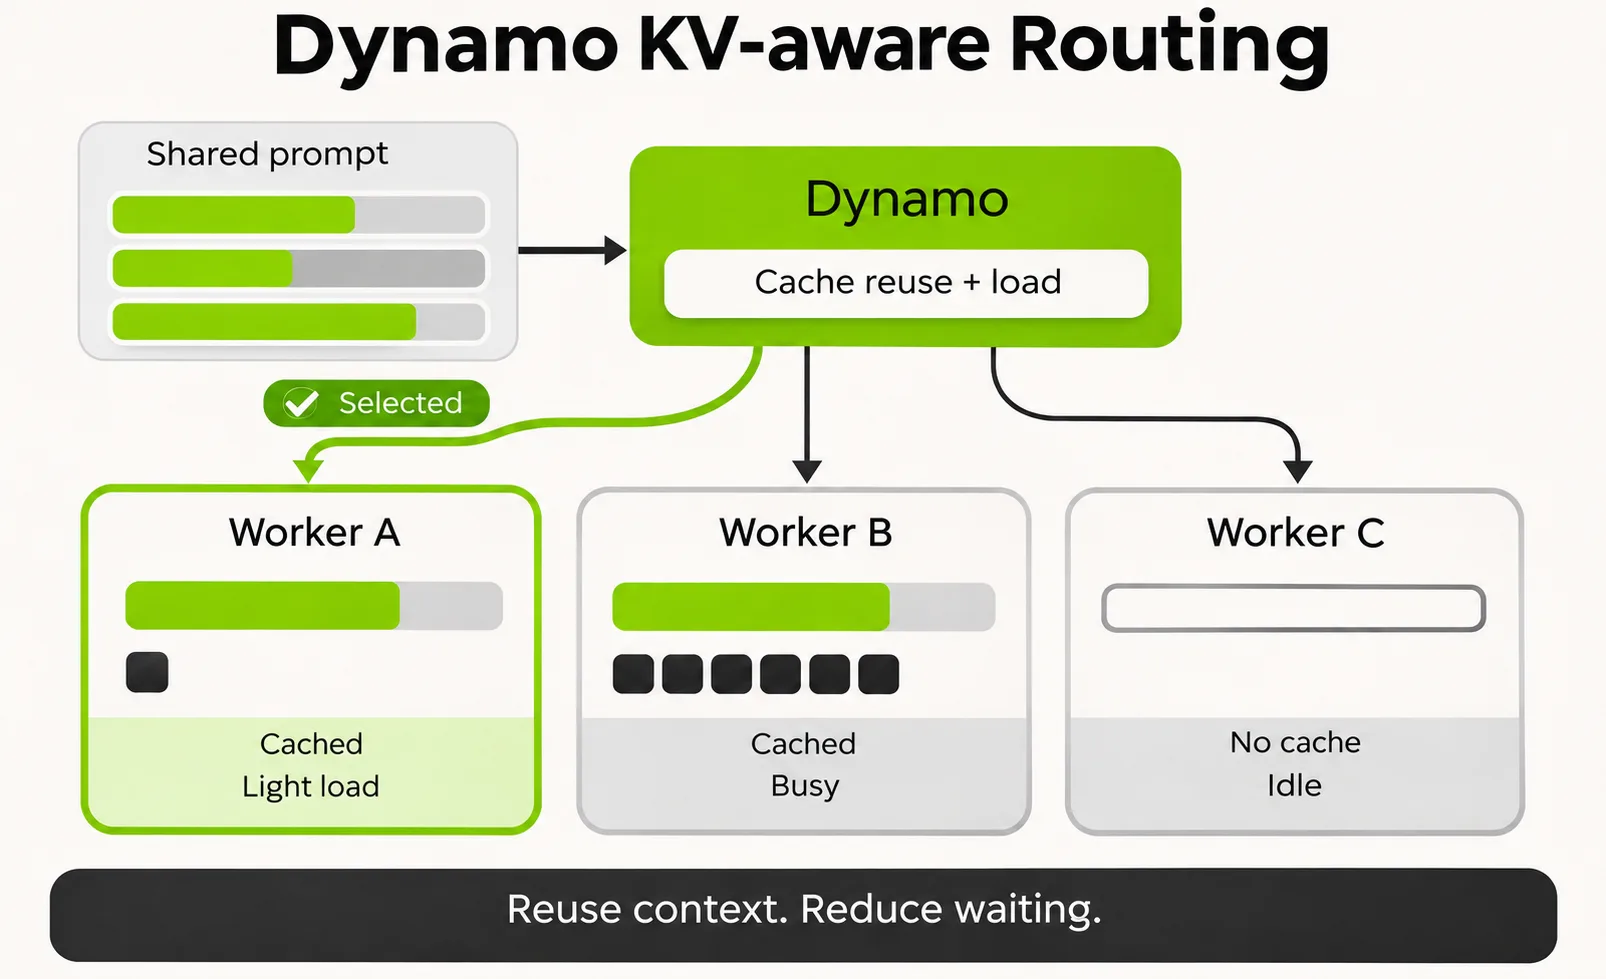
Enrutamiento compatible con KV: reduzca el recuento de velocidades
RL a menudo realiza múltiples soluciones para la misma tarea utilizando motivación compartida. Enviar estas solicitudes a un trabajador que haya almacenado en caché la velocidad evita el procesamiento repetitivo y ahorra rendimiento de la GPU. Pero delegar todas las solicitudes a ese empleado puede crear colas, retrasar las producciones y hacer necesaria una capacitación de seguimiento.
El enrutador de Dynamo equilibra el uso de la caché KV con las cargas de trabajo de los trabajadores para reducir la latencia y la latencia. El objetivo es completar las muestras necesarias para la formación lo antes posible.
ModelExpress: Reducir la distribución de múltiples pesos anterior
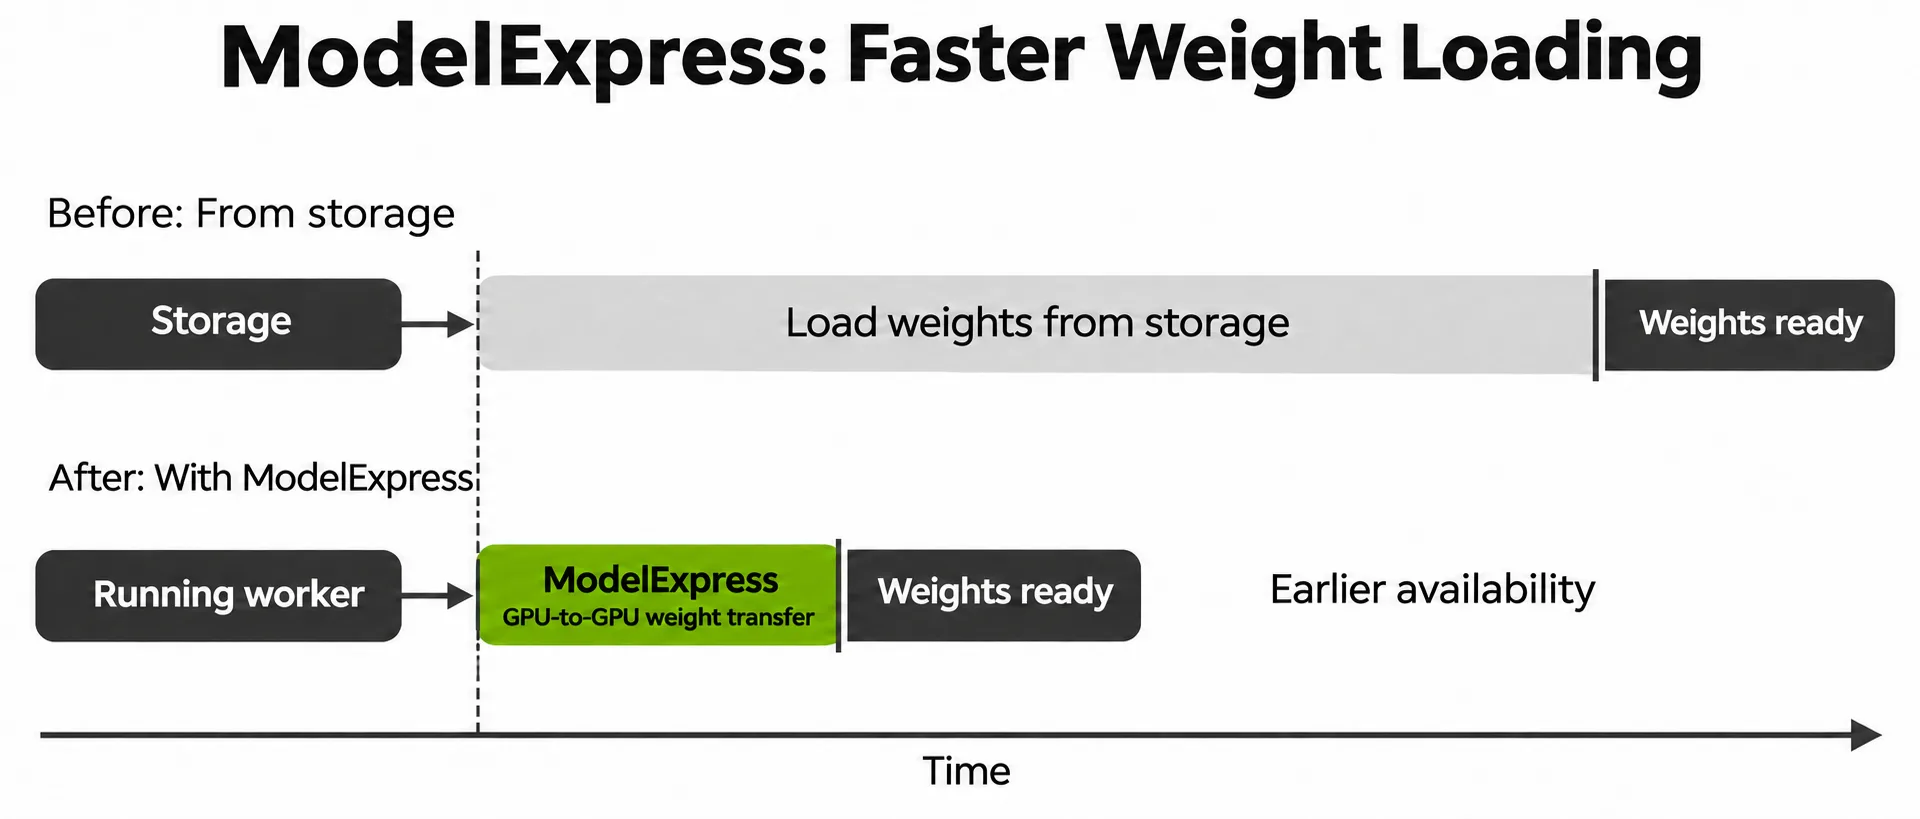
El entrenamiento RL es una actualización del modelo. Asignar un punto de control a todos los empleados puede llevar mucho tiempo y comprometer la productividad.
ModelExpress minimiza esta característica al reutilizar los pesos disponibles en el clúster pero sin cargarlos desde el almacenamiento remoto. Los trabajadores compatibles pueden copiar cargas de trabajo de otra GPU para NIXL.
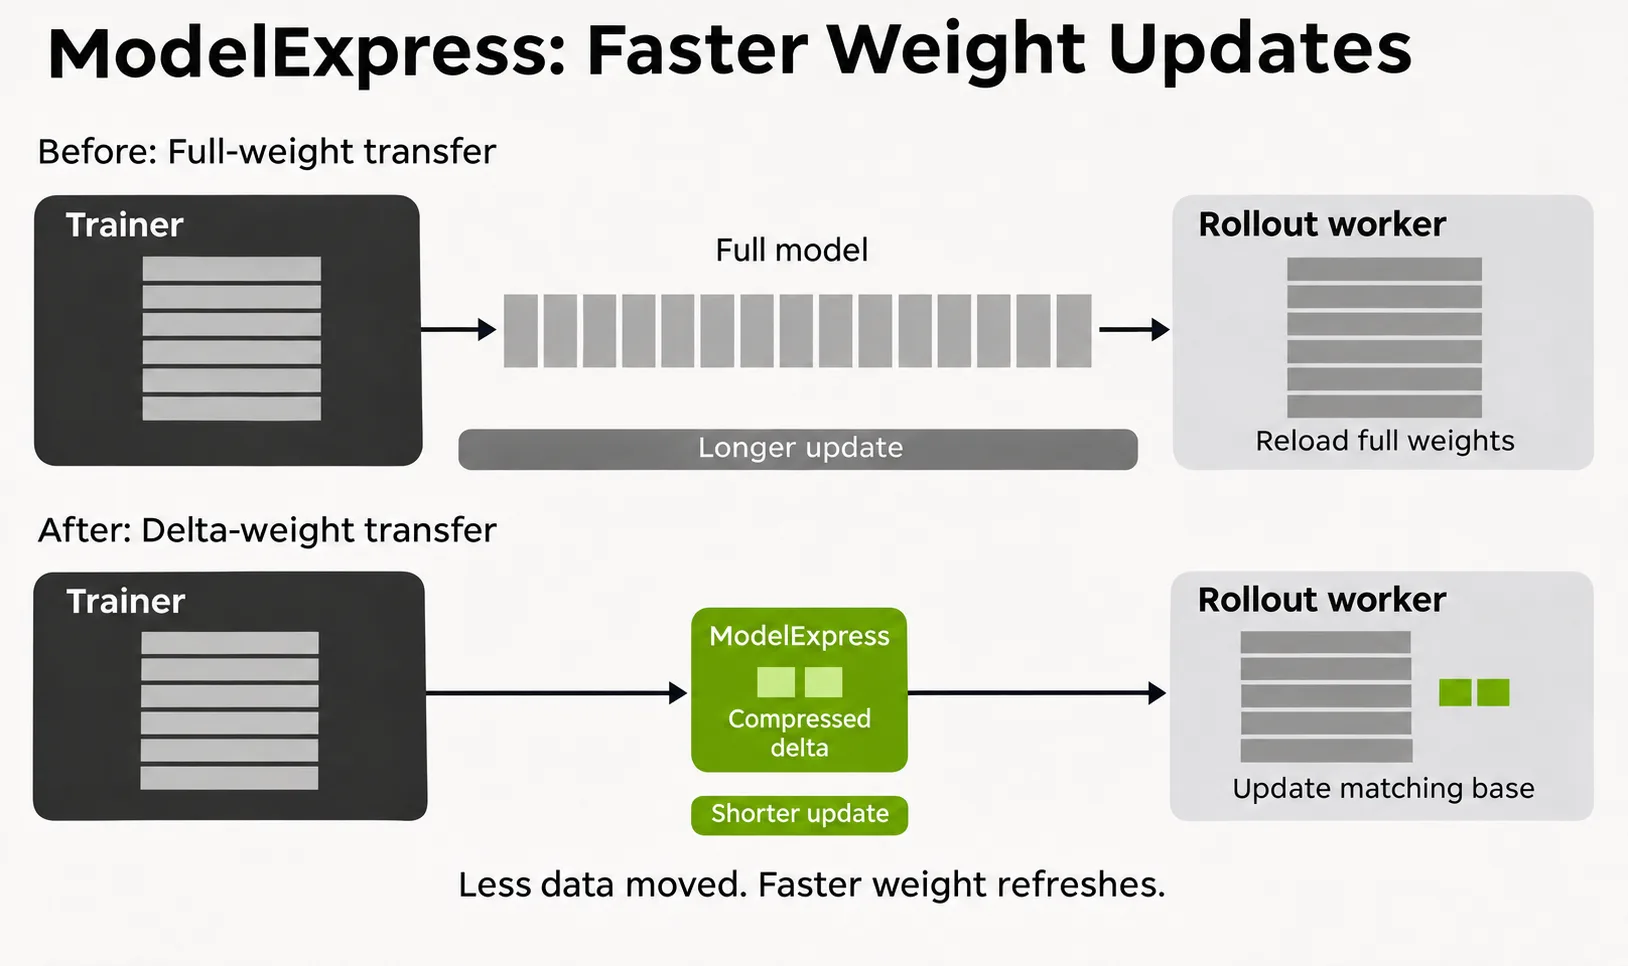
La transferencia de peso delta reduce la cantidad de datos enviados entre actualizaciones. En lugar de mover todo el modelo, proporciona una indicación adicional de lo que ha cambiado. Los trabajadores también crean nuevos pesos a partir de la versión base correspondiente, lo que reduce el tiempo de transferencia y el tráfico de la red.
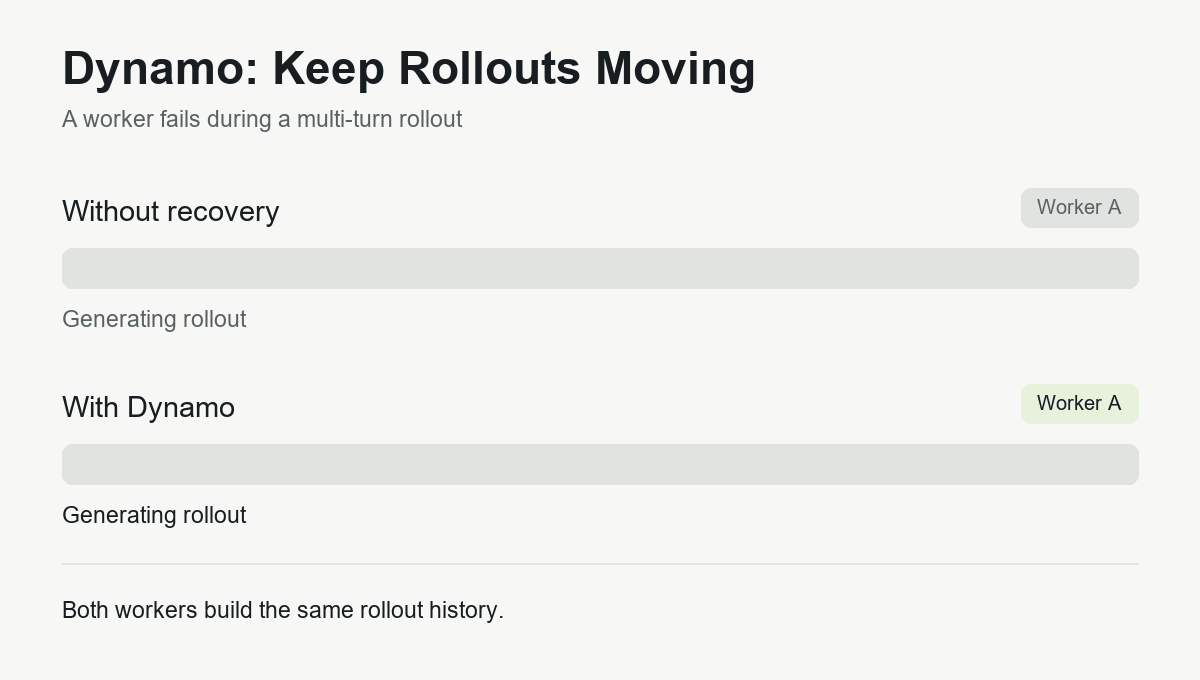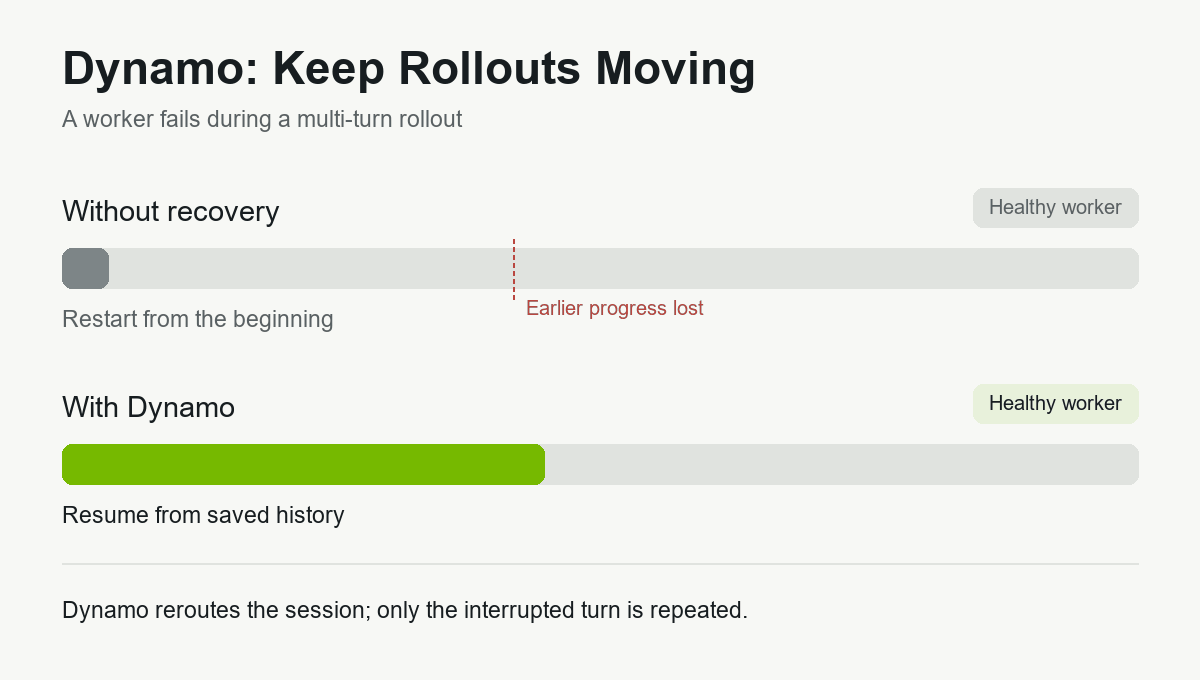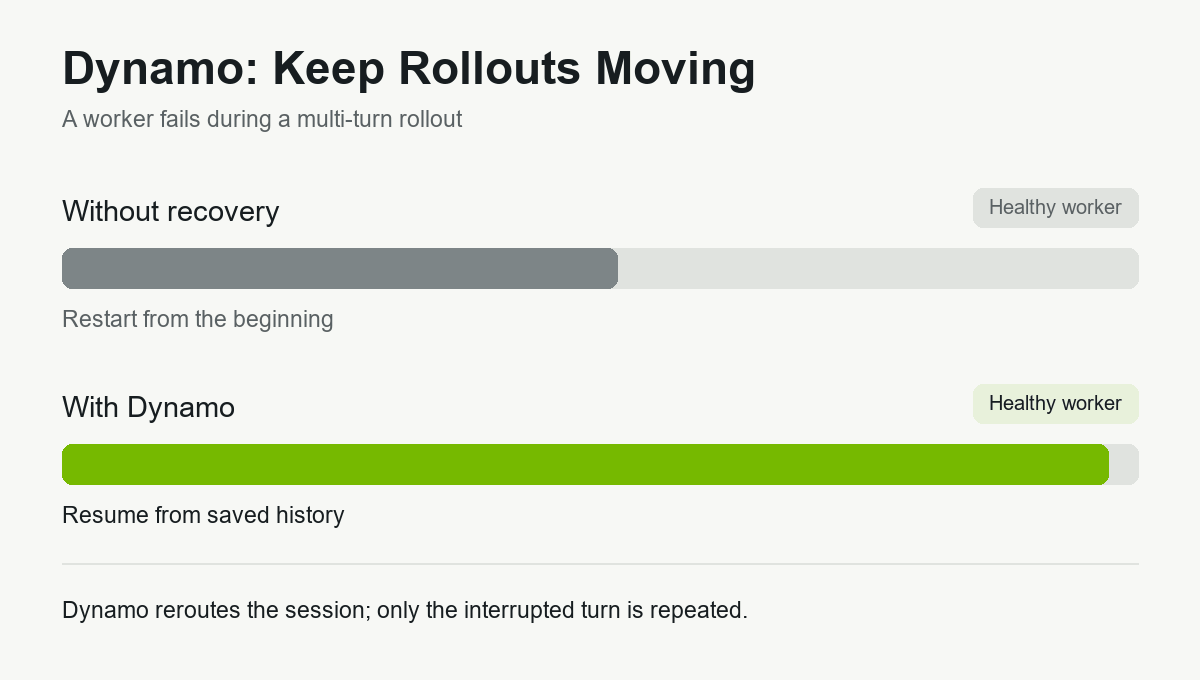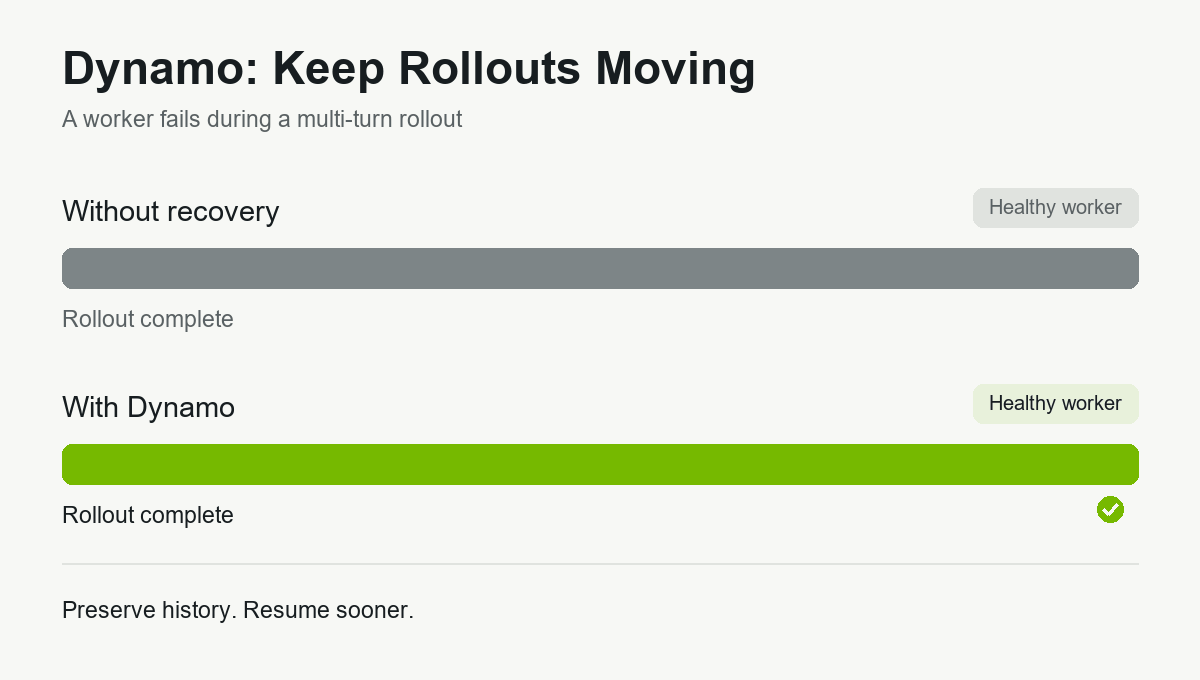
Esto también ayuda en la recuperación. Un trabajador sustituto puede cargar un punto de control y seguir los siguientes pasos para completar una ejecución de capacitación. El personal médico puede continuar produciendo tan pronto como se recuperen las fuerzas.
El marco RL controla cuándo los trabajadores solicitan actualizaciones, administra el estado de la caché y verifica la preparación antes de aceptar nuevas instancias.
Recuperación: Minimizar el impacto de las fallas de los empleados
Los entrenamientos prolongados deben adaptarse a las debilidades del personal sin comprometer la salud.
Dynamo detecta cuándo se pierden trabajadores, envía nuevas solicitudes a trabajadores calificados y agrega trabajadores de reemplazo a la cartera cuando está listo, manteniendo a la generación en movimiento cuando un trabajador falla.
Las configuraciones de soporte también se pueden migrar para aplicaciones de aeronaves con una migración eficiente.
El marco RL maneja modelos truncados y garantiza que los reemplazos utilicen los pesos requeridos.
Dynamo en flujos de trabajo de RL
La adopción de Dynamo en RL se extiende al desarrollo de modelos paso a paso, infraestructura de gestión y marcos de código abierto:
Empecemos con Dynamo para RL
Una buena estructura de RL mantiene la tasa de producción, la distribución de la carga y el ahorro de mano de obra en movimiento. Dynamo incorpora estas capacidades de rendimiento al entorno de capacitación, lo que ayuda a los equipos a convertir la potencia de la GPU distribuida en modelos de capacitación aprobados a alta velocidad.
Explore el artículo de Dynamo RL y comience a sacar provecho del proverbio detrás de su próximo ejemplo.
Gracias
Aichen Feng, Biswa Ranjan Panda, Elaine Hou, Hyunjae Woo, Jinyan Chen, John Thomson, Sean Choi, Sophia Yang, William Arnold y Zhongdongming Dai contribuyeron a esta publicación.